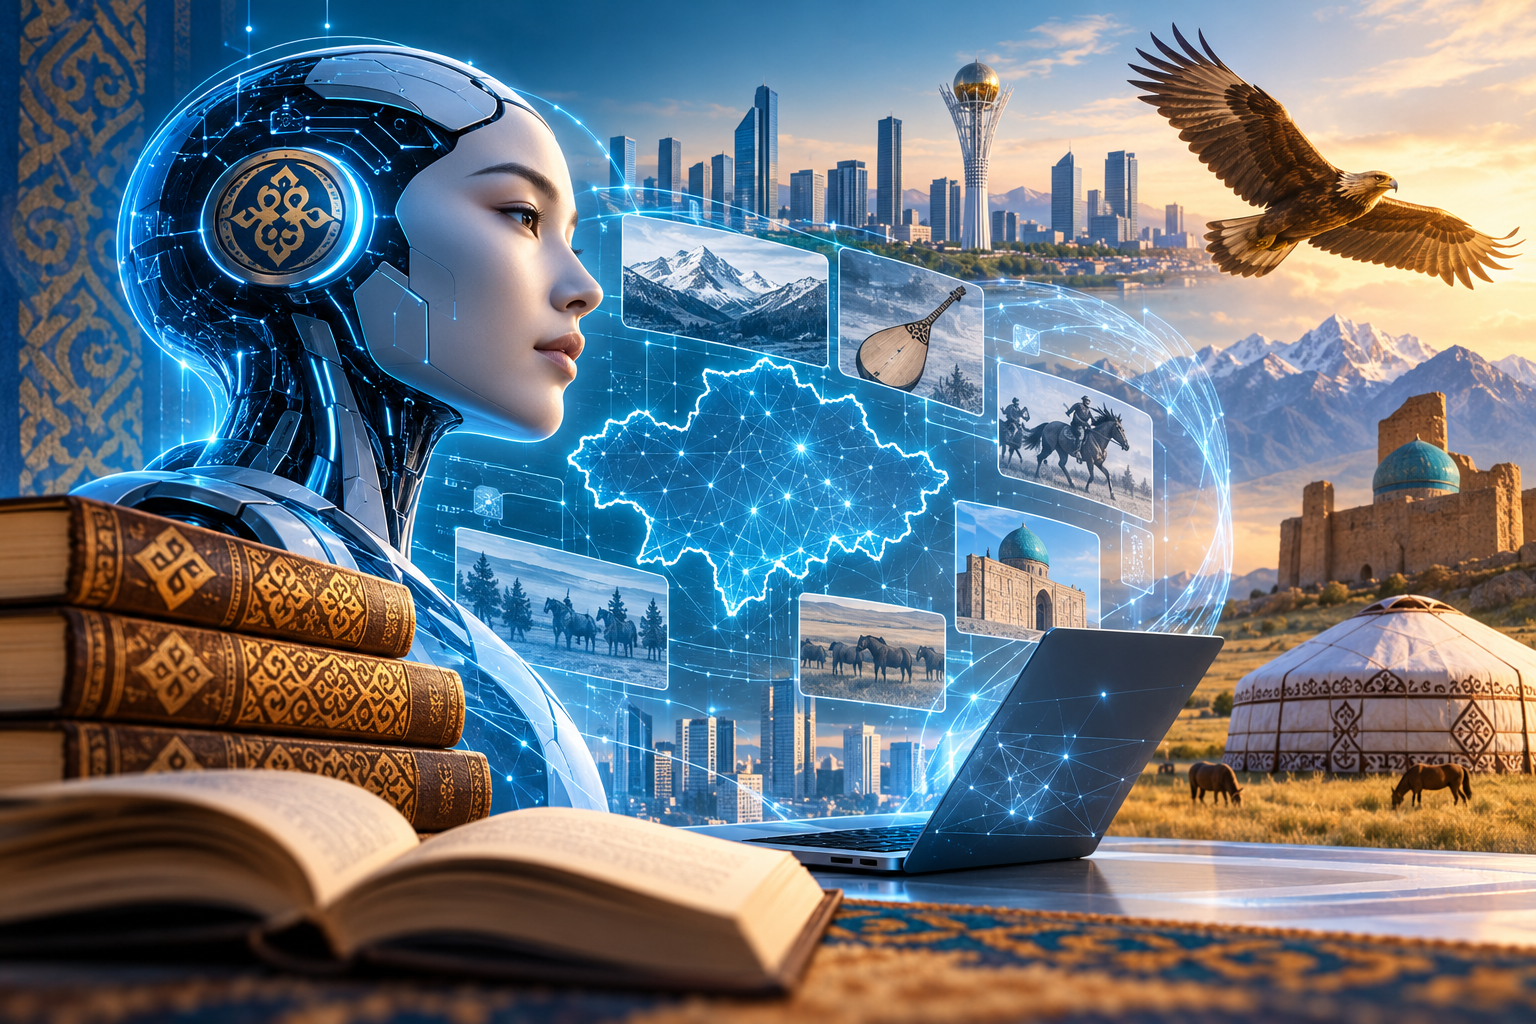
Жасанды интеллект дәуірінде тілдің болашағы оның күнделікті қолданысымен ғана емес, жаңа технологияларда қаншалықты толық әрі табиғи қолданылатынымен де байланысты. Қазір әлемдегі ірі тілдік модельдердің көпшілігі ағылшын тіліндегі ауқымды деректерге сүйенеді. Сондықтан қазақ тіліне, Қазақстанның тарихы мен мәдениетіне, жергілікті ұғымдар мен қоғамдық тәжірибеге қатысты ақпарат мұндай жүйелерде толық қамтылмауы немесе бұрмаланып берілуі мүмкін. Осы тұрғыдан алғанда, қазақ тілін жасанды интеллект кеңістігінде дамыту – тілдік қана емес, ғылыми-технологиялық әрі мәдени міндет.
Қазақстанда осы бағытта жасалған маңызды қадамдардың бірі – KazLLM үлкен тілдік моделінің әзірленуі. Жобаның ғылыми-техникалық жұмыстарын Назарбаев Университеті жанындағы Ақылды жүйелер және жасанды интеллект институты (ISSAI) 2024 жылғы сәуір мен желтоқсан аралығында жүргізді. KazLLM цифрлық даму, ғылым және жоғары білім салаларына жауапты министрліктердің қолдауымен, отандық ғылыми ұйымдар мен технологиялық серіктестердің бірлескен күш-жігері нәтижесінде жүзеге асты. Жобаға қазақстандық компаниялар, жоғары оқу орындары, ғылыми мекемелер мен ақпараттық технологиялар саласындағы ұйымдар атсалысты. Оның ғылыми-техникалық маңызы модельді әзірлеумен ғана шектелмейді. Жоба барысында қазақстандық зерттеушілер мен инженерлер ауқымды тілдік модельдермен жұмыс істеудің практикалық тәжірибесін жинақтап, отандық мамандардың кәсіби құзыретін дамытуға негіз қаланды.
Жобаның айрықша маңызы – әзірлеу ісіне қазақстандық мамандардың тікелей қатысып, күрделі технологияны өз күшімен игеруінде. Негізгі ғылыми және инженерлік жұмыстарды машиналық оқыту, деректер ғылымы мен компьютерлік инженерия салаларындағы отандық зерттеушілер атқарды. Олар деректерді жинау мен дайындаудан бастап, модельді оқыту, сынау және бағалауға дейінгі кезеңдерде тәжірибе жинақтады. Осылайша KazLLM-ның нәтижесі дайын модельмен ғана өлшенбейді: жоба жергілікті кадрлардың кәсіби біліктілігін арттыруға, үлкен тілдік модельдермен жұмыс істей алатын зерттеушілер мен инженерлердің тәжірибесін кеңейтуге және ел ішіндегі ғылыми-технологиялық әлеуетті нығайтуға ықпал етті.
ISSAI KazLLM-ның екі нұсқасын әзірледі: 8 миллиард және 70 миллиард параметрлі модельдер. Олардың негізіне Llama 3.1 модельдер тобы алынды. Бұл жерде KazLLM нөлден бастап жасалған дербес архитектура емес, қолданыстағы модель негізінде жергілікті тілдік міндеттерге бейімделген жүйе екенін ескерген жөн. Оны әзірлеу барысында қазақ тіліндегі мүмкіндіктерге ерекше мән берілді, сонымен қатар модель бірнеше тілмен жұмыс істеуге бағытталды.
ISSAI жариялаған сынақ нәтижелеріне сәйкес, KazLLM нұсқалары қазақ тіліне бейімделген бенчмарктердегі жиынтық көрсеткіш бойынша негізге алынған Llama модельдерінен жоғары нәтиже көрсетті. 2024 жылғы желтоқсандағы бағалауда KazLLM 70B жекелеген көрсеткіштер бойынша GPT-4o нәтижелеріне жақындаған. Дегенмен бұл салыстыру сол кезеңде қолданылған нақты тесттерге қатысты; оны модельдердің барлық міндет бойынша бірдей деңгейде жұмыс істейтініне дәлел ретінде қабылдауға болмайды.
KazLLM-ды ChatGPT тәрізді дайын цифрлық қызметпен де шатастырмау қажет. Үлкен тілдік модель – болашақ сервистерге негіз бола алатын технологиялық өзек. Оның негізінде қазақ тілінде сұраққа жауап беретін көмекшілерді, білім беру құралдарын, мекемелердің ішкі ақпараттық жүйелеріне арналған шешімдерді дамытуға болады. Бірақ мұндай өнімдерді көпшілікке ұсыну үшін модельді қосымша бейімдеу, сенімді дереккөздермен байланыстыру, қауіпсіздік тетіктерін енгізу және тұрақты есептеу инфрақұрылымын қамтамасыз ету керек. ISSAI мәліметінше, KazLLM-ның ашық нұсқалары зерттеу мақсатында қолданылады; ал оның нақты коммерциялық немесе мемлекеттік жүйелерде қаншалықты кең енгізілгені туралы мәліметті бөлек растау қажет.
Ұлттық тілдік модель жасаудың мәні тек қазақша мәтін құрастыруға қабілетті жүйе әзірлеуде емес. Тіл арқылы халықтың тарихи жады, дүниетанымы, дәстүрі, әлеуметтік қатынастары мен ұғымдар жүйесі беріледі. Жасанды интеллект қазақша сауатты сөйлегенімен, ұлттық мәдениеттің астарын немесе белгілі бір тарихи оқиғаның контексін қате түсіндіруі мүмкін. Сондықтан цифрлық кеңістіктегі ұлттық кодты сақтау үшін модельдің тілдік сауатымен қатар, пайдаланылатын деректердің мазмұндық дәлдігіне және мәдени сәйкестігіне назар аудару қажет.
Бұл жұмыста сапалы қазақша дерек қоры шешуші рөл атқарады. Ғылыми еңбектер, энциклопедиялық материалдар, тарихи деректер, әдебиет пен салалық мәтіндер цифрлық форматта неғұрлым жүйелі және сапалы ұсынылса, оларды жасанды интеллект жүйелерін дамытуға пайдалану мүмкіндігі соғұрлым артады. Бірақ интернетке жарияланған кез келген мәтін автоматты түрде модельдің біліміне айналмайды: деректерді іріктеу, құқықтық талаптарды сақтау, сапасын тексеру және оқыту нәтижесін бағалау қажет.
Мұнда инженерлердің еңбегімен қатар тілші ғалымдардың, тарихшылардың, мәдениеттанушылардың, педагогтердің және салалық сарапшылардың қатысуы маңызды. Технологиялық мамандар модельді жасаса, гуманитарлық сала өкілдері тілдік норма, терминология, тарихи дәлдік пен мәдени мазмұн тұрғысынан оның сапасын бағалауға көмектеседі. Мұндай ынтымақтастық қазақ тілін жасанды интеллект жүйелерінде тек қолданылатын тіл ретінде емес, мазмұны толық әрі сенімді білім тілі ретінде орнықтыруға мүмкіндік береді.
KazLLM жобасы халықаралық деңгейде де назар аударды. ISSAI дерегі бойынша, жасанды интеллект зерттеушісі Янн ЛеКун 2025 жылғы Париж саммитінде жоба нәтижелерін атап өткен. Сол жылы KazLLM жобасына байланысты VEON, Beeline Kazakhstan және QazCode компаниялары GSMA Foundry Excellence Awards марапатының жасанды интеллект санатында жеңімпаз атанды. Алайда жобаның ұзақ мерзімді құндылығы марапаттармен емес, оның негізінде қалыптасқан тәжірибенің қалай жалғасатынымен, мамандардың қалай өсетінімен және қазақ тіліндегі технологиялардың нақты сапасымен өлшенеді.
Жасанды интеллект саласы үздіксіз жаңарып отырады. Сондықтан бір модельді әзірлеу – аяқталған жұмыс емес, келесі зерттеулерге жол ашатын кезең. Қазақстан үшін маңыздысы – осы бағыттағы ғылыми мектепті дамыту, жергілікті кадрларды тұрақты даярлау, сапалы деректерді көбейту және жасалған технологияларды қоғам қажеттілігіне сай жетілдіру.
Ұлттық кодты цифрлық дәуірде сақтау – қазақ тіліндегі мәліметтердің санын арттырумен ғана шектелмейді. Ол тілдің табиғатын, тарихи жады мен мәдени мағыналарын жаңа технологияларда дұрыс жеткізуге жағдай жасауды білдіреді. KazLLM осы жолдағы маңызды тәжірибенің бірі болды. Ал қазақ тілінің жасанды интеллект дәуіріндегі орны мемлекет, ғылым, технология саласы және қоғам бірлесе атқаратын жүйелі жұмысқа байланысты.
KazLLM және қазақ тіліндегі ЖИ: ұлттық кодты цифрлық дәуірде қалай сақтап қаламыз?
19.10.2026
200
Yorumlar